Przy standardowym poziomie istotności 5 procent około jedna piąta efektów uznanych za statystycznie istotne w testach A/B okazuje się przypadkowa, co przy skali polskiego e-commerce, wartego w 2024 roku około 150 mld zł, oznacza realne straty finansowe. Błędy takie jak przedwczesne kończenie testu, brak zapisanej hipotezy, testowanie kilku zmian naraz czy rozjazd proporcji ruchu między wariantami wciąż powtarzają się w polskich sklepach internetowych. Konkretne progi liczby konwersji, czasu trwania testu i podziału ról w zespole pozwalają odróżnić realny efekt zmiany od przypadkowego wahania danych.
Polski e-commerce wygenerował w 2024 roku sprzedaż o wartości około 150 mld zł brutto (Izba Gospodarki Elektronicznej, 2024), więc nawet niewielka poprawa współczynnika konwersji przekłada się na realne miliony złotych przychodu.
Tymczasem przy standardowym poziomie istotności 5 procent około jedna piąta efektów oznaczanych jako statystycznie istotne w testach A/B okazuje się w rzeczywistości przypadkowa (Ron Berman, 2022).
Rzetelny eksperyment wymaga jasnej hipotezy, odpowiedniej próby i kontroli jakości danych, zanim zespół ogłosi zwycięski wariant i wdroży go na stałe.
Dlaczego skala polskiego e-commerce nie wybacza testów na wyczucie
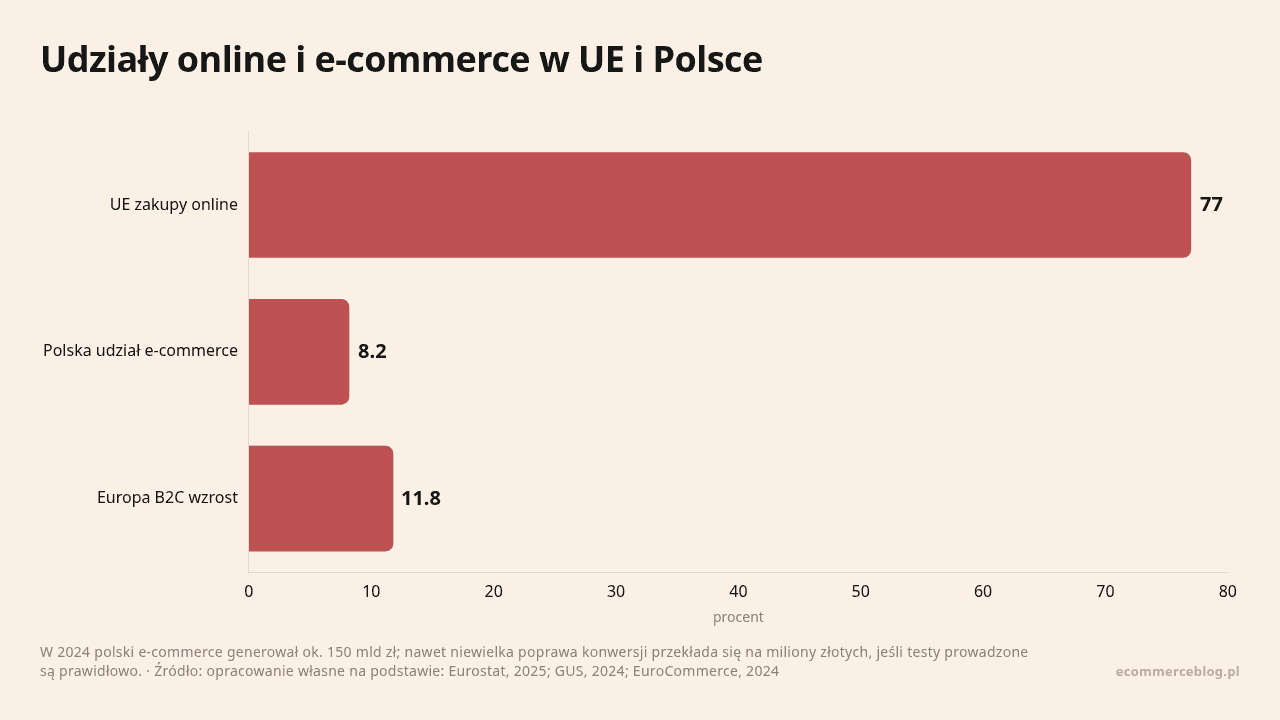
W 2024 roku zakupy online zrobiło 77 procent internautów w Unii Europejskiej w wieku od 16 do 74 lat (Eurostat, 2025).
W Polsce w czerwcu 2024 roku sprzedaż detaliczna przez internet wzrosła rok do roku o 11,8 procent, a udział e-commerce w sprzedaży detalicznej ogółem sięgnął 8,2 procent (GUS, 2024).
Cały europejski rynek B2C e-commerce urósł w 2023 roku z 864 do 887 mld euro (EuroCommerce, 2024).
Przy takiej skali obrotu ręczne decyzje projektowe oparte na przeczuciu przestają się opłacać. Sklep, który zmienia układ karty produktu bez sprawdzenia wpływu na konwersję, ryzykuje utratę przychodu liczonego w tysiącach złotych miesięcznie, zanim ktokolwiek zauważy błąd. Eksperymenty kontrolowane są jedynym sposobem, by odróżnić realny efekt zmiany od przypadkowego wahania ruchu.
Udziały online i e-commerce w UE i Polsce
Najczęstsze błędy statystyczne, które fałszują wyniki testów
W polskich sklepach internetowych powtarzają się podobne błędy, niezależnie od branży:
zbyt wczesne kończenie testu, gdy wariant „wygląda na zwycięzcę”, zanim osiągnie zaplanowaną liczbę konwersji (Mouseflow, 2026; Esellsphere, 2026),
brak z góry zapisanej hipotezy i głównej metryki, co prowadzi do wybiórczej interpretacji wyniku po fakcie (Shopify, 2024),
testowanie kilku zmian naraz, na przykład nowego koloru przycisku, innej treści i innego układu sekcji jednocześnie, co uniemożliwia wskazanie, co naprawdę zadziałało (Esellsphere, 2026),
brak korekty na wielokrotne testowanie, gdy kilka eksperymentów działa równolegle na podobnej grupie użytkowników,
ignorowanie różnic między segmentami, na przykład zakładanie, że wynik trafny dla desktopu sprawdzi się też na smartfonie (Mouseflow, 2026),
błędna randomizacja i rozjazd proporcji ruchu między wariantami, czyli sample ratio mismatch (arXiv, 2022).
Część tych problemów przypomina błędy przy wdrażaniu AI w sklepie, od danych po testy, opisane w 12 błędach przy wdrażaniu AI w sklepie. Zła jakość danych wejściowych psuje wynik niezależnie od tego, czy modelujesz algorytm rekomendacji, czy sprawdzasz wariant strony produktu.
Protip ecommerceblog.pl: wprowadź wewnętrzną listę zakazanych zachowań przy testach A/B, na przykład zakaz przerywania testu przed uzyskaniem ustalonej liczby konwersji na wariant i zakaz zmiany kryteriów sukcesu w trakcie jego trwania.
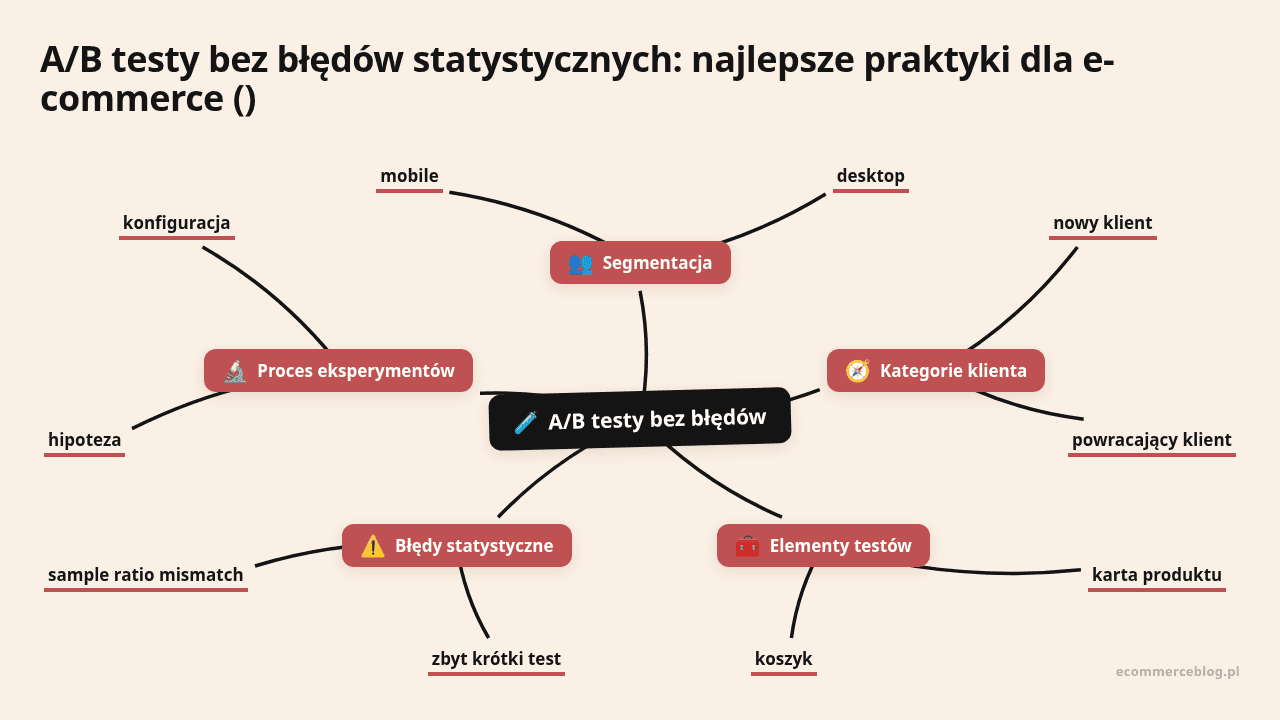
Mapa myśli: A/B testy bez błędów statystycznych: najlepsze praktyki dla e-commerce ()
Jak formułować hipotezy i wybierać metrykę sukcesu
Każdy test A/B zaczyna się od trzech elementów zapisanych zanim ktokolwiek dotknie kodu: celu biznesowego, hipotezy i metryki głównej (TheCommerceShop, 2025; Shopify, 2024; Esellsphere, 2026).
Dobra hipoteza łączy konkretną zmianę z przewidywanym skutkiem i uzasadnieniem, na przykład: „dodanie informacji o darmowej dostawie od określonej wartości koszyka na stronie produktu zwiększy współczynnik dodania do koszyka, ponieważ usuwa niepewność dotyczącą kosztu dostawy” (Esellsphere, 2026).
Metryka główna zależy od miejsca w lejku:
lista produktów i karta produktu: kliknięcia w kartę, dodania do koszyka, przejścia do koszyka,
koszyk: odsetek dokończonych zamówień, wartość koszyka,
płatność: ukończenie zamówienia, czas realizacji transakcji.
Metryki pomocnicze, takie jak czas na stronie czy liczba kliknięć w konkretny element, mogą uzupełniać obraz. Decyzję o zwycięskim wariancie powinna podejmować jedna, wcześniej wybrana metryka główna, zamiast zestawu kilku wskaźników naraz.
Ile próby i czasu potrzeba, żeby wynik był wiarygodny
Wiarygodny test A/B wymaga jednocześnie odpowiedniej liczby konwersji i czasu, który obejmuje pełny cykl zakupowy klienta. Poradniki dla e-commerce zalecają co najmniej od 100 do 200 konwersji na wariant oraz czas trwania od 14 do 28 dni, w zależności od natężenia ruchu (Esellsphere, 2026; Medium, 2025; Mouseflow, 2026).
Poziom ruchu
Minimalna liczba konwersji na wariant
Orientacyjny czas trwania
Komentarz
Niski
od 100 do 200
od 4 do 8 tygodni
krótszy okres nie uwzględnia pełnego cyklu zakupowego
Średni
od 200 do 1000
od 2 do 4 tygodni
trzeba objąć pełne tygodnie, nie tylko dni robocze
Wysoki
powyżej 1000
od 14 do 21 dni
nawet duży ruch wymaga uwzględnienia weekendów i dni wypłat
Test uruchomiony na fragmencie tygodnia albo w środku dużej kampanii promocyjnej pokazuje zniekształcony obraz zachowań klientów.
Protip ecommerceblog.pl: nie zaczynaj testu na stronie koszyka lub płatności tuż przed dużą kampanią promocyjną i tuż po niej. Najbardziej wiarygodny wynik uzyskasz w miesiącu z powtarzalną strukturą ruchu.
Sample ratio mismatch i testy A/A: kontrola jakości platformy eksperymentów
Rozjazd proporcji ruchu między wariantem A i B, gdy rzeczywisty podział nie zgadza się z konfiguracją testu, nazywa się sample ratio mismatch. To sygnał błędu w systemie kierowania ruchu albo w integracji z narzędziem eksperymentów (arXiv, 2022), a nie przypadkowe wahanie.
okresowe testy A/A, czyli porównanie dwóch identycznych wariantów, aby sprawdzić, czy sama platforma nie wprowadza systematycznych różnic (arXiv, 2022),
unikanie równoległych testów na tej samej podstronie i tym samym segmencie użytkowników w tym samym czasie,
stała kontrola rzeczywistych proporcji ruchu: jeśli konfiguracja przewiduje podział 50 do 50, a dane wskazują istotne odchylenie, test trzeba zatrzymać i zbadać przyczynę.
Regularne testy A/A i stały monitoring proporcji ruchu chronią przed wnioskami wyciągniętymi z danych zepsutych już na starcie eksperymentu.
Podobny problem, tylko po stronie pomiaru, opisuje tekst o błędach w GA4, które fałszują wyniki: dane zepsute u źródła prowadzą do wniosków, które wydają się poprawne, a nie mają pokrycia w rzeczywistym zachowaniu klientów.
Protip ecommerceblog.pl: w zespołach prowadzących wiele testów jednocześnie wyznacz osobę odpowiedzialną wyłącznie za jakość platformy eksperymentów, czyli za monitorowanie sample ratio mismatch, testy A/A i blokowanie konfliktujących eksperymentów na tych samych stronach.
Segmentacja wyników: urządzenia, źródła ruchu i personalizacja z AI
Zmiana, która podnosi konwersję na komputerze, może równocześnie obniżać ją na smartfonie, dlatego wynik testu warto zawsze rozbić na segmenty (Mouseflow, 2026).
urządzenie: komputer i laptop, smartfon, tablet,
źródło ruchu: wyszukiwarka, reklama płatna, newsletter, media społecznościowe,
typ klienta: nowy klient, klient powracający, klient z programem lojalnościowym.
Coraz częściej testom A/B podlegają same algorytmy rekomendacji produktowych oparte na uczeniu maszynowym. Wymaga to dłuższego okresu pomiaru, ponieważ mechanizm personalizacji musi zdążyć zebrać dane o zachowaniu użytkownika, zanim jego działanie się ustabilizuje. Architektura headless, opisana szerzej w tekście o hype i rzeczywistości headless commerce, ułatwia wdrażanie takich wariantów niezależnie od głównego kodu sklepu.
Wynik testu, który wygląda dobrze dla całej populacji, może skrywać stratę w jednym z kluczowych segmentów, dlatego decyzję o wdrożeniu warto podejmować dopiero po sprawdzeniu podziałów.
Kto w zespole odpowiada za testy A/B
Testy A/B to proces złożony z kilku etapów: hipoteza, konfiguracja, przeprowadzenie testu, analiza wyniku, dokumentacja (Esellsphere, 2026).
W praktyce uczestniczą w nim cztery role:
zespół produktowy: identyfikuje problemy w doświadczeniu użytkownika i priorytetyzuje hipotezy według potencjalnego wpływu na przychód,
zespół marketingu: dba o testy komunikacji, wezwań do działania i treści na stronie głównej, zachowując spójność z kampaniami zewnętrznymi,
analityk danych: dobiera metryki, liczy wielkość próby, kontroluje czas trwania testu i pilnuje błędów statystycznych,
zespół IT lub dostawca technologii: wdraża warianty w narzędziu testowym i zapewnia poprawny podział ruchu.
Gdy sklep rośnie i przybywa jednoczesnych eksperymentów, brak jasnego podziału ról prowadzi do chaosu podobnego do tego, który opisuje tekst o błędach w skalowaniu e-commerce, gdy rośnie ruch, gdy procesy nie nadążają za rosnącym ruchem.
Uporządkowany proces testowania chroni przed powtarzaniem tych samych eksperymentów i zgubieniem wniosków z poprzednich miesięcy.
Strategia testów dla sklepów z małym i dużym ruchem
Strategia eksperymentowania różni się w zależności od wolumenu ruchu w sklepie.
Wolumen ruchu
Liczba równoległych testów
Zakres elementów
Czas trwania
Duży (setki tysięcy użytkowników miesięcznie)
kilka testów na różnych podstronach jednocześnie
karty produktu, wezwania do działania, komunikaty o dostawie, proces płatności
od 14 do 21 dni
Mały (kilka tysięcy użytkowników miesięcznie)
jeden test w danym okresie
strona o najwyższym ruchu lub kluczowy etap lejka
od 4 do 8 tygodni
Przy mniejszym ruchu testy A/B warto uzupełniać analizą jakościową, na przykład mapami cieplnymi i nagraniami sesji, ponieważ liczba konwersji rośnie zbyt wolno, aby szybko potwierdzić drobne zmiany (Medium, 2025; Mouseflow, 2026).
Mały sklep zyskuje więcej na testowaniu dużych zmian, takich jak skrócenie formularza zamówienia, niż na sprawdzaniu koloru pojedynczego przycisku, który przy niskim ruchu nigdy nie osiągnie istotności statystycznej.
Protip ecommerceblog.pl: przy małym ruchu zrezygnuj z testowania detali bez wyraźnego potencjału wpływu na konwersję. Skoncentruj się na zmianach, które mają szansę wywołać widoczny efekt, na przykład uproszczeniu formularza zamówienia albo jasnym komunikatem o kosztach dostawy.
Redakcja ecommerceblog.pl
Na ecommerceblog.pl pomagamy właścicielom sklepów internetowych budować przewagę technologiczną, wdrażając rozwiązania typu headless oraz AI i dostarczając zasoby na temat najnowszych trendów w e-handlu oraz strategii biznesowych. Wspieramy w cyfrowej transformacji, ucząc, jak wykorzystać nowoczesne technologie do dominacji na rynku.
Newsletter
Subskrybuj dawkę wiedzy
Wypróbuj bezpłatne narzędzia
Skorzystaj z narzędzi, które ułatwiają codzienna pracę!
Wieloletnie badania Baymard Institute pokazują, że średnio 70% koszyków zakupowych zostaje porzuconych na etapie finalizacji…
Redakcja ecommerceblog.pl
7 kwietnia 2026
Zarządzaj zgodą
Aby zapewnić jak najlepsze wrażenia, korzystamy z technologii, takich jak pliki cookie, do przechowywania i/lub uzyskiwania dostępu do informacji o urządzeniu. Zgoda na te technologie pozwoli nam przetwarzać dane, takie jak zachowanie podczas przeglądania lub unikalne identyfikatory na tej stronie. Brak wyrażenia zgody lub wycofanie zgody może niekorzystnie wpłynąć na niektóre cechy i funkcje.
Funkcjonalne
Zawsze aktywne
Przechowywanie lub dostęp do danych technicznych jest ściśle konieczny do uzasadnionego celu umożliwienia korzystania z konkretnej usługi wyraźnie żądanej przez subskrybenta lub użytkownika, lub wyłącznie w celu przeprowadzenia transmisji komunikatu przez sieć łączności elektronicznej.
Preferencje
Przechowywanie lub dostęp techniczny jest niezbędny do uzasadnionego celu przechowywania preferencji, o które nie prosi subskrybent lub użytkownik.
Statystyka
Przechowywanie techniczne lub dostęp, który jest używany wyłącznie do celów statystycznych.Przechowywanie techniczne lub dostęp, który jest używany wyłącznie do anonimowych celów statystycznych. Bez wezwania do sądu, dobrowolnego podporządkowania się dostawcy usług internetowych lub dodatkowych zapisów od strony trzeciej, informacje przechowywane lub pobierane wyłącznie w tym celu zwykle nie mogą być wykorzystywane do identyfikacji użytkownika.
Marketing
Przechowywanie lub dostęp techniczny jest wymagany do tworzenia profili użytkowników w celu wysyłania reklam lub śledzenia użytkownika na stronie internetowej lub na kilku stronach internetowych w podobnych celach marketingowych.